
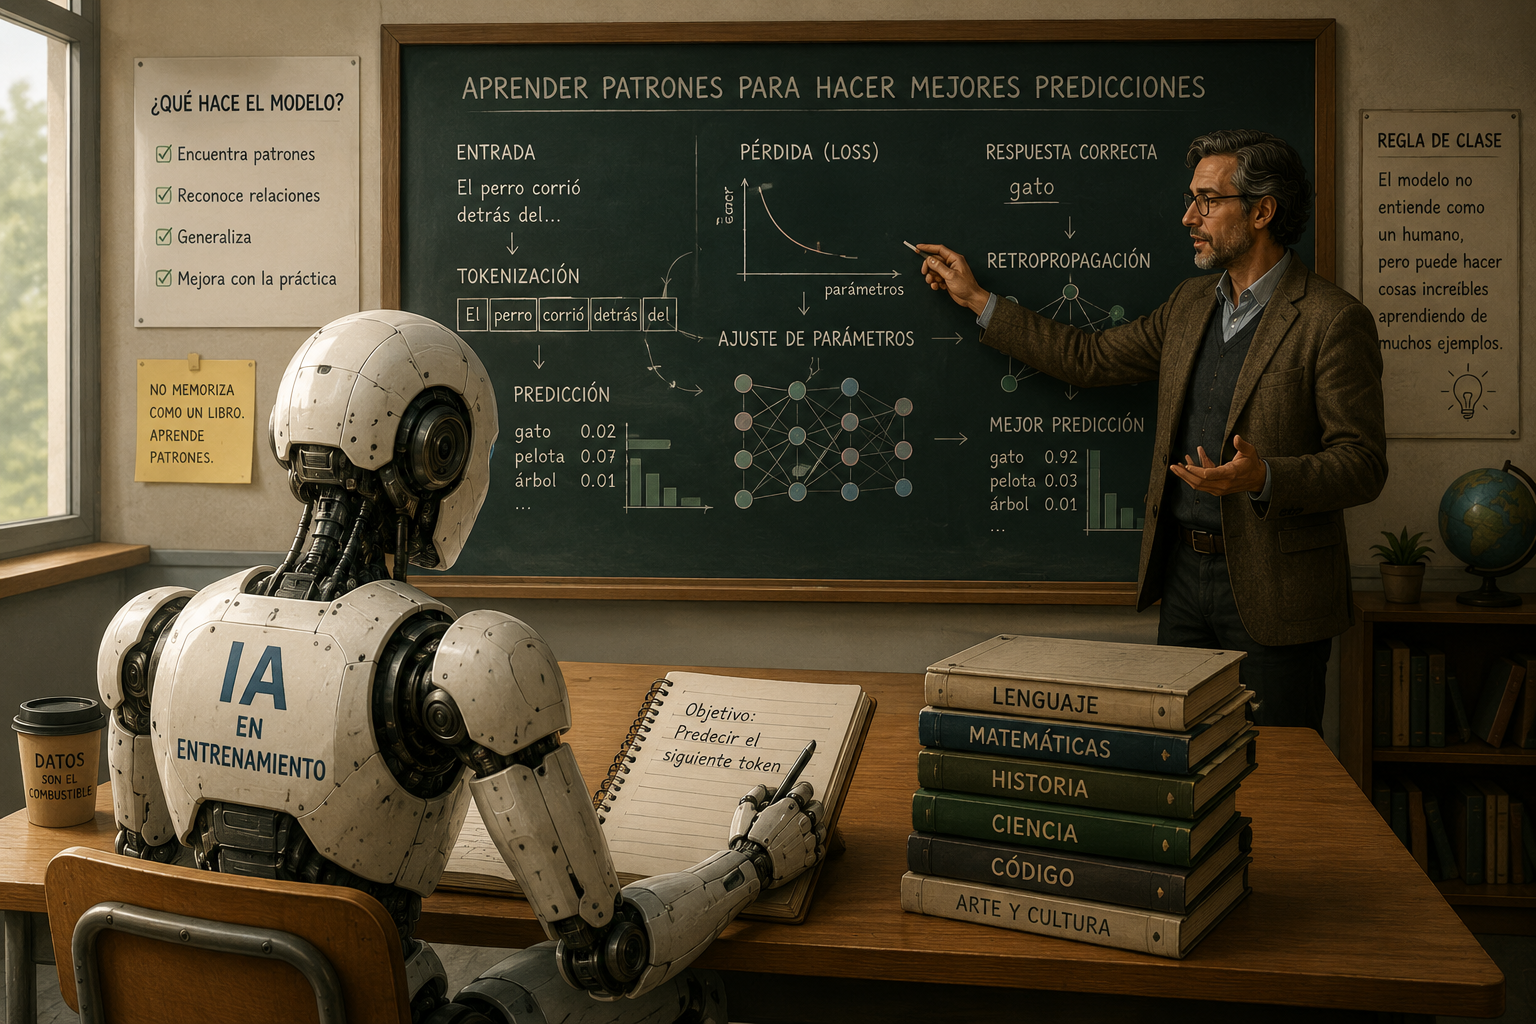
¿Pero qué coño significa entrenarlo?

Creo que, antes de todo, debemos hacer algo elemental para poder entender hacia dónde vamos en este barullo. Y empezaría destruyendo una imagen mental que confunde muchísimo.
Cuando alguien dice:
«Entrenaron el modelo con enormes cantidades de texto.»
Cualquier cristiano puede imaginarse que hicieron algo parecido a llenar una biblioteca digital: la atiborraron de libros, Wikipedia, páginas web, código, artículos… y cuando llega el momento en que preguntas, la máquina busca allí dentro.
O sea, ¿lee?
¡Noooo! Esa no es, ni de cerca, una buena representación de lo que allí ocurre.
Pero antes de seguir hay que hacer una aclaración importante, porque probablemente algunos hayan leído durante los últimos meses una historia que parece decir exactamente lo contrario.
Sí, hubo libros. Y sí, algunos terminaron destruidos.
En el caso de Anthropic existe documentación judicial de que la empresa compró millones de libros impresos, muchos de ellos usados, retiró sus encuadernaciones, cortó las páginas, las escaneó y posteriormente descartó las copias físicas. De esa manera creó archivos digitales que pasaron a formar parte de una biblioteca de investigación utilizada, entre otros propósitos, para seleccionar material destinado al entrenamiento de modelos.
La imagen resulta bastante poderosa:
millones de libros → máquinas → inteligencia artificial.
Casi parece que estamos alimentando a un monstruo con bibliotecas.
Pero aquí es precisamente donde debemos separar dos cosas:
Una cosa es de dónde proceden los datos utilizados para entrenar un modelo.
Otra muy diferente es qué ocurre con esos datos durante el entrenamiento y cómo funciona el modelo una vez entrenado.
Que un libro haya sido digitalizado y su contenido utilizado como material de entrenamiento no significa que el modelo terminado conserve una copia de ese libro en una biblioteca interna y vaya a buscarla cuando hacemos una pregunta.
El contenido utilizado durante el entrenamiento puede influir en los parámetros que el modelo aprende y, como veremos más adelante, determinados fragmentos pueden incluso ser memorizados. Pero eso es diferente de imaginar una base de datos llena de libros esperando ser consultados.
Así que no neguemos la historia de los libros.
Los libros existieron. Algunos fueron comprados, cortados, escaneados y destruidos físicamente.
Lo que debemos desmontar es otra cosa:
que entrenar una IA consista simplemente en meter esos libros dentro de una gigantesca biblioteca digital que después la máquina consulta.
Ahora sí.
Empecemos con una máquina que no sabe un coño
Imaginemos un modelo recién inicializado.
Le damos:
«El perro salió corriendo detrás del…»
Y ocultamos lo siguiente.
Supongamos que el texto original decía:
Gato.
El modelo tiene que predecir qué viene inmediatamente después.
Al comienzo sus parámetros todavía no han sido ajustados mediante el aprendizaje que buscamos, por lo que sus predicciones pueden ser pésimas. Podría asignar probabilidades absurdas:
gato 0,02%
avión 3%
zapato 7%
democracia 4%
Estoy inventando esos porcentajes solamente para explicar el mecanismo.
Entonces ocurre algo fundamental:
Nosotros conocemos cuál era el token que realmente seguía en el texto.
Un token, para no complicarnos la existencia todavía, es una unidad en la que se divide el texto para que el modelo pueda procesarlo. Puede ser una palabra completa, una parte de una palabra o incluso un signo de puntuación.
En nuestro ejemplo, lo que seguía era:
gato.
Así que matemáticamente podemos medir:
«Te equivocaste, cabrón.»
Y ahora viene el entrenamiento.
El sistema calcula cómo modificar ligeramente sus parámetros para que la predicción correcta resulte más probable en contextos como ese.
Y los modifica.
Pero atención:
No guarda o archiva una ficha que diga: «después de perro viene gato».
Hace algo diferente:
ajusta una enorme cantidad de valores numéricos un poquito.
Después:
Otro texto.
Predicción.
Error.
Ajuste.
Otro.
Predicción.
Error.
Ajuste.
Y así una cantidad gigantesca de veces.
Eso, dicho de una forma extremadamente simplificada, está en el corazón del entrenamiento.
¿Qué coño son esos «parámetros»?
Aquí es donde normalmente nos asesinan con lenguaje técnico.
Por ahora pensemos en ellos simplemente como perillas numéricas internas ajustables.
No hay una perilla que diga:
PERROS = 0,7483
Tampoco otra que diga:
SHAKESPEARE = 0,9281.
Son valores distribuidos por toda la red que participan conjuntamente en las operaciones matemáticas que producen una predicción.
Un modelo moderno puede tener miles de millones de esos valores.
Durante el entrenamiento hay que determinar cómo modificarlos para reducir el error. Y ahí aparecen algunas de esas palabras que nos lanzan siempre:
loss = una medida matemática del error.
gradient = información matemática que indica cómo cambia ese error cuando modificamos los parámetros.
gradient descent = un procedimiento que utiliza esa información para ir modificando los parámetros buscando reducir el error.
backpropagation = el procedimiento que permite calcular los gradientes necesarios a través de las distintas capas de la red para poder ajustar sus parámetros.
Ahora tiremos temporalmente esos nombres a la basura.
Para la plebe:
intentó → medimos el error → ajustamos → volvió a intentar.
Ese es el corazón que necesitamos entender.
Pero aquí aparece algo mucho más interesante
Si fundamentalmente le estamos enseñando a predecir qué viene después…
¿Cómo coño termina manejando geografía, gramática, programación, historia y relaciones entre conceptos?
Porque para mejorar sus predicciones en una cantidad gigantesca de contextos, el modelo necesita capturar patrones, relaciones y regularidades presentes en los datos.
Por ejemplo:
«París es la capital de…»
Para predecir Francia consistentemente, algo en la estructura interna del modelo tiene que terminar permitiéndole manejar relaciones que hagan probable esa respuesta.
Pero no todo es una asociación tan sencilla.
Pensemos:
«Juan metió el helado en el horno y cinco minutos después…»
Para producir una continuación razonable tiene que manejar relaciones entre:
helado, temperatura, horno, tiempo, derretimiento…
Y esas relaciones no tuvieron que ser introducidas una por una por un programador mediante reglas como:
SI HELADO + HORNO = DERRETIR.
El proceso de entrenamiento va modificando los parámetros mientras el modelo aprende regularidades útiles para mejorar sus predicciones.
Y aquí debemos colocar una baranda.
De esto no se desprende automáticamente:
«Por tanto, comprende como un humano.»
Pero tampoco podemos reducir todo el proceso a:
«solamente tiene una lista de palabras que suelen aparecer juntas».
Son discusiones diferentes.
Lo que sí podemos decir es algo más modesto:
el objetivo de entrenamiento puede consistir en predecir el siguiente token y, sin embargo, para mejorar en esa tarea el modelo puede aprender patrones y relaciones mucho más complejos que una simple lista de qué palabra suele seguir a otra.
Ahora sí: ¿qué coño es un token?
Cuando escribimos:
«El perro salió corriendo detrás del gato.»
el modelo no necesariamente recibe esa oración dividida exactamente en esas palabras.
El texto se transforma en tokens: unidades que pueden corresponder a palabras completas, partes de palabras, signos de puntuación u otras unidades de texto.
Por eso cuando decimos coloquialmente:
«predice la siguiente palabra»
nos sirve para entenderlo.
Pero es más correcto decir:
«predice el siguiente token».
Y eso nos permite corregir otra frase habitual:
«La IA lee internet.»
Bueno…
No «lee» internet durante el entrenamiento exactamente como Rey abre Reuters y lee un artículo.
Los datos son preparados, convertidos en representaciones que el sistema puede procesar y utilizados durante un proceso matemático que modifica los parámetros del modelo.
Y cuando termina el entrenamiento, ¿dónde están los libros?
Ahora podemos regresar a los libros del principio.
La respuesta simplificada es:
no hay una biblioteca convencional dentro del modelo.
No funciona como una base de datos en la que cada documento de entrenamiento permanece guardado en un estante esperando que posteriormente alguien lo solicite.
Lo que queda después del entrenamiento son, entre otras cosas, los parámetros modificados por ese proceso de aprendizaje.
Pero tampoco debemos pasarnos al otro extremo y afirmar:
«Los modelos nunca memorizan nada.»
Eso tampoco sería correcto.
Existe evidencia experimental de que los modelos de lenguaje pueden memorizar determinados fragmentos de sus datos de entrenamiento y que, bajo ciertas condiciones, parte de ese material puede incluso ser reproducido literalmente.
Por tanto, para nuestro propósito basta con algo mucho más sencillo:
entrenamiento ≠ meter documentos en una base de datos.
Eso sí.
Pero hasta ahora solamente hemos hablado de una parte
Lo que hemos descrito corresponde principalmente al:
PREENTRENAMIENTO
Después de ese enorme proceso tenemos lo que podemos llamar, simplificando, un modelo base.
Pero un modelo que ha aprendido a predecir y continuar texto no necesariamente sabe comportarse como el asistente con el que conversamos.
Para eso existe otra etapa:
POST-ENTRENAMIENTO
Aquí empiezan otros procesos destinados a moldear cómo utiliza el modelo las capacidades adquiridas.
Se pueden utilizar ejemplos de respuestas, entrenamiento para seguir instrucciones, evaluaciones y preferencias sobre diferentes respuestas, aprendizaje por refuerzo y otros métodos. Los procedimientos concretos varían según el modelo y la empresa.
Para la plebe podemos conservar una simplificación:
Preentrenamiento:
el modelo aprende patrones y relaciones presentes en enormes cantidades de datos.
Post-entrenamiento:
se trabaja sobre cómo utilizar esas capacidades y cómo responder a determinadas instrucciones.
No son definiciones académicas completas.
Pero nos permiten saber de qué coño estamos hablando cuando aparecen esas palabras.
Cuando escribo:
Y después llega Rey
«Alucín, explícame qué significa entrenar un modelo.»
el modelo que está respondiendo no se está reentrenando conmigo en ese momento.
Lo que está ocurriendo se llama:
INFERENCIA
El modelo utiliza los parámetros que ya fueron aprendidos durante su entrenamiento para procesar el contexto que tiene delante y producir una respuesta.
Y aquí tenemos tres cajones que conviene no volver a mezclar:
ENTRENAMIENTO
Modifica los parámetros del modelo.
INFERENCIA
Utiliza el modelo ya entrenado para producir una salida.
CONTEXTO
Es la información que el modelo tiene disponible durante una interacción para producir su respuesta. Que utilice esa información no significa por sí mismo que sus parámetros estén siendo modificados en tiempo real.
Eso desmonta otra frase que escuchamos muchísimo:
«La IA aprendió lo que le dije.»
Puede haber mecanismos separados mediante los cuales determinadas conversaciones sean posteriormente utilizadas para mejorar modelos futuros, dependiendo del producto, sus políticas y la configuración del usuario.
Pero eso es diferente de afirmar que cada conversación está reentrenando instantáneamente el modelo con el que hablamos.
Y ahora sí podemos mirar el proceso completo sin necesidad de convertirnos en ingenieros:
datos
↓
tokens
↓
el modelo intenta predecir
↓
error
↓
se calcula cómo reducirlo
↓
los parámetros se ajustan
↓
el proceso se repite una cantidad gigantesca de veces
↓
modelo base
↓
post-entrenamiento
↓
modelo preparado para interactuar de determinadas maneras
↓
inferencia: escribimos un prompt y el modelo ya entrenado responde
Y después de entender todo esto aparece otra pregunta.
Quizás la más interesante:
Si durante el entrenamiento nadie le escribió explícitamente todas las reglas que termina siendo capaz de utilizar…
¿qué exactamente aprendió dentro de esos miles de millones de números?
Pero esa…
es otra madriguera.

Deja un comentario