
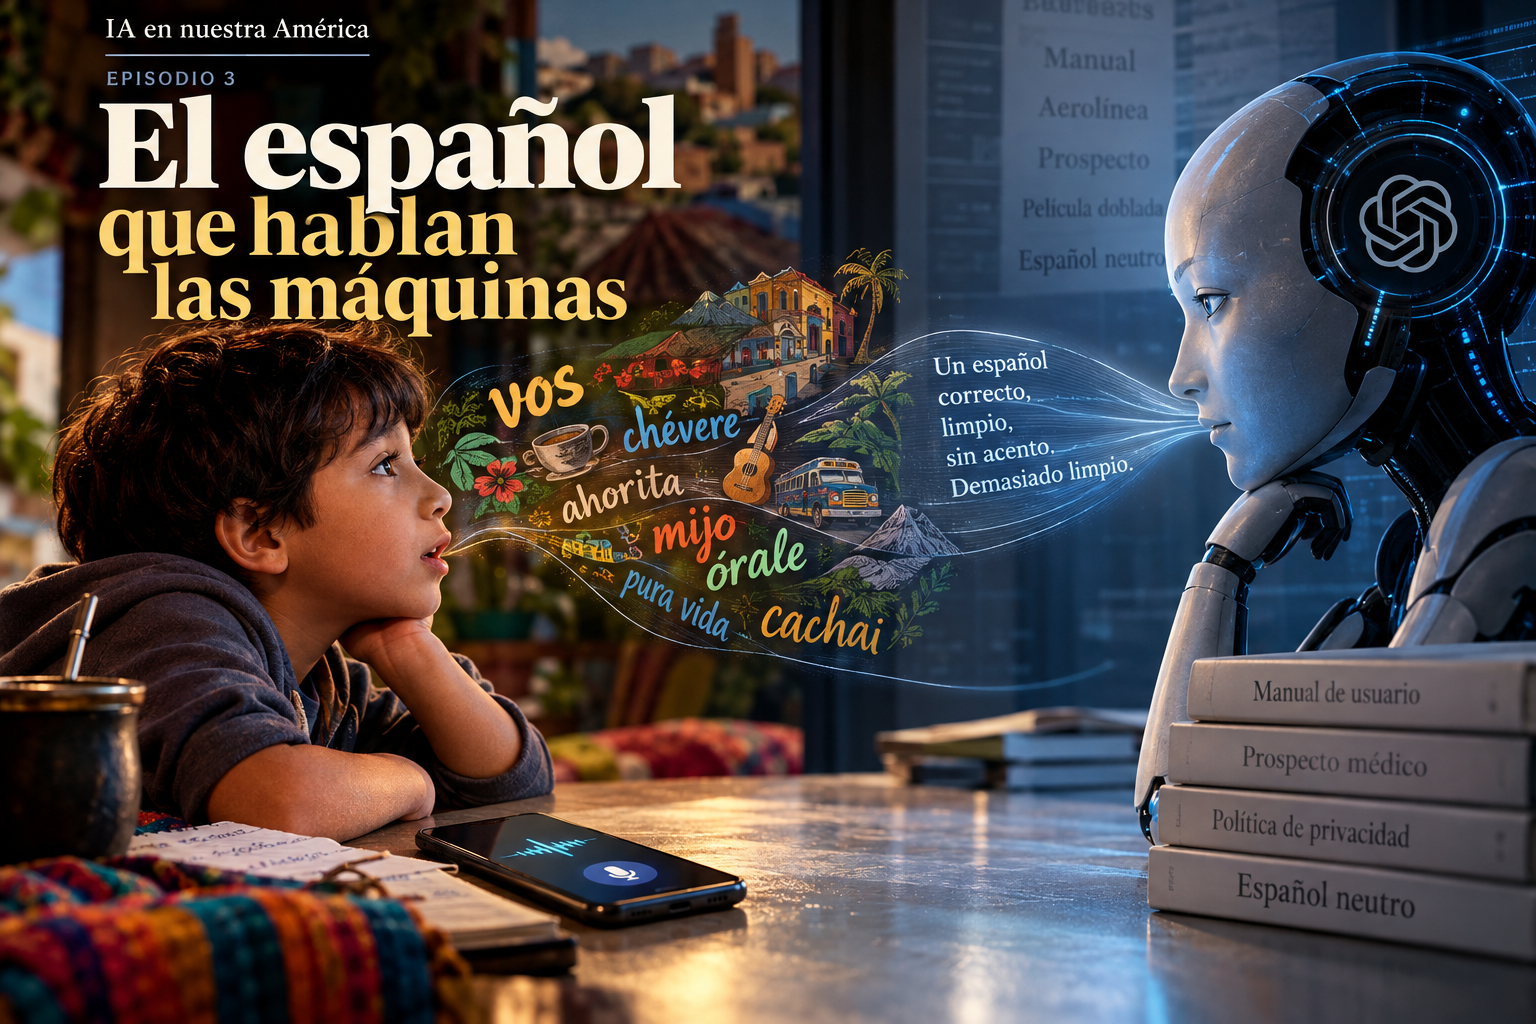
¿Estamos enseñando a las máquinas a hablar nuestro idioma… o estamos cambiando nuestra manera de hablar para que ellas nos entiendan?

Episodio 3 — Serie «IA en nuestra América»
Escribí «vos» en el teléfono y el teléfono me lo cambió por «voz». Sin preguntar. Yo quería decirle a un amigo «vos sabés que eso no fue así», y el aparato decidió que yo había querido decir otra cosa.
Lo corregí a mano, como quien deshace una grosería ajena, y me quedé un rato mirando la pantalla. La máquina no me entendió, y en vez de admitirlo, me corrigió.
Esa anécdota me la contaba un amigo de origen argentino. La verdad es que al inicio me causó risa. Un hombre entrado en años queriendo entender por qué su celular tomaba decisiones aparentemente aleatorias.
No es la primera vez que he sido testigo de ese tipo de situaciones. Viví en Venezuela muchos años y allí me pasaba, sobre todo, con palabras muy autóctonas. El corrector me subrayaba «chévere» con una rayita roja, como un maestro de escuela cansado. Me sugería cambiar «ahorita» por «ahora mismo». Cuando dicto un mensaje de voz y digo «mijo», la transcripción puede escribir «mi hijo»: muy correcta, muy muerta.
En cosas pequeñas, la máquina puede devolvernos nuestro español pasado por un filtro. Y ese filtro, algunas veces, quita precisamente lo que distingue nuestra manera de hablar: la orilla, la calle, la casa.
Porque las máquinas hablan español. Eso dicen. Pero ¿qué español hablan?
Pídale usted a uno de estos asistentes que le explique algo y escuche bien. Muchas veces encontrará un español correcto, limpio, sin una procedencia regional fácilmente reconocible. Demasiado limpio. Es el español de los manuales de aerolínea, de los prospectos de medicina, de las películas dobladas. Un español neutro, dicen. Neutro como el agua destilada: sin sabor, sin mineral, sin memoria.
No significa que estos sistemas desconozcan el «vos», el «órale», el «chévere», el «pura vida» o el «cachai». Pueden utilizarlos y, en muchos casos, reconocer sus significados. La pregunta es otra: ¿cuántas veces aparecen espontáneamente en sus respuestas y cuántas veces tenemos que pedirles que hablen como nosotros?
Yo crecí escuchando ese español. Venía en las películas dobladas: un español de laboratorio que nadie hablaba en mi barrio pero que todos entendíamos, como se entiende a un primo lejano. La diferencia es que aquel español no contestaba. Era una voz de fondo.
El de ahora habla con nosotros todos los días, nos redacta los correos, nos resume las reuniones, nos contesta las preguntas. Y lo que se repite todos los días termina sonando normal.
¿De dónde salió ese español? ¿Quién decidió que así hablamos?
La respuesta es un poco incómoda: nadie lo votó. Porque la transición no se vota, se financia.
Los grandes modelos de lenguaje se desarrollaron durante años con una presencia dominante del inglés en sus datos de entrenamiento. No es una sospecha: hay cifras que permiten comprobarlo.
En GPT-3, por ejemplo, el inglés representaba aproximadamente el 92,65 % de las palabras de su conjunto de entrenamiento, frente al 0,77 % del español. En LLaMA 2, la distribución publicada mostraba un 89,70 % de inglés y apenas un 0,13 % de español.
Son cifras correspondientes a modelos concretos, no a todos los sistemas actuales. Tampoco significa que la proporción de idiomas sea idéntica en cada generación de modelos. Pero permiten observar algo importante: una parte fundamental de esta tecnología se desarrolló sobre una base lingüística profundamente desigual.
Y hay algo más.
Investigaciones sobre el funcionamiento interno de algunos modelos han encontrado representaciones especialmente próximas al inglés incluso cuando reciben preguntas en otros idiomas. Estudios sobre la familia Llama 2 y otros sistemas sugieren que, durante ciertas etapas del procesamiento, el inglés puede funcionar como una especie de lengua intermediaria.
Sin embargo, no todos los modelos siguen necesariamente ese comportamiento. Otras investigaciones, realizadas con sistemas entrenados sobre datos multilingües más equilibrados, encuentran representaciones que involucran diferentes idiomas.
Dicho en otras palabras: no podemos afirmar que toda máquina piense en inglés y después traduzca al español. Pero sí tenemos motivos para preguntarnos cuánto influye el predominio del inglés en el español que finalmente recibimos.
Y esa pregunta no es menor.
En ocasiones encontramos construcciones que parecen trasladadas directamente del inglés: «hace sentido» en lugar de «tiene sentido», o «eventualmente» utilizado con el significado de «finalmente». Son usos que también circulan entre hablantes humanos y que no podemos atribuir exclusivamente a la inteligencia artificial. Pero cuando aparecen en respuestas automáticas, cabe preguntarse qué papel desempeñan los datos de entrenamiento y los patrones que los modelos han aprendido.
La traducción como una forma de influencia cultural. Nadie desembarcó con banderas. Simplemente, una tecnología desarrollada principalmente alrededor del inglés comenzó a escribir también en nuestro idioma.
¿Y quién decidió cómo hablan español las máquinas?
Las empresas que desarrollan los modelos, los equipos de investigación, las decisiones sobre los datos, los procedimientos de entrenamiento y los criterios utilizados para evaluar las respuestas participan en ese resultado.
También intervienen personas que revisan y califican respuestas. Sus evaluaciones ayudan a definir qué se considera útil, correcto o apropiado. No sabemos que todos esos procesos favorezcan deliberadamente un español neutro. Pero sí sabemos que las decisiones técnicas y humanas influyen en la manera en que estos sistemas terminan expresándose.
No lo decidió ninguna academia por sí sola. Tampoco lo decidieron exclusivamente los escritores ni la gente que habla español en la calle, en la cocina o en el camión.
La escala tiene mucho que ver.
¿Cómo construir un sistema capaz de responder a millones de personas que comparten un idioma, pero no necesariamente sus expresiones, sus acentos ni sus referencias culturales?
La industria busca respuestas que puedan funcionar para públicos muy amplios. Y allí aparece una tensión: lo que resulta comprensible para muchos puede terminar perdiendo parte de lo que distingue a cada comunidad.
En ese momento, siendo participantes pero con poca voz o voto, hicimos algo que siempre nos funciona: aceptamos los términos.
Utilizamos los correctores, los asistentes, los sistemas de transcripción. Les entregamos palabras, preguntas y expresiones, aunque eso no significa que todos los servicios utilicen esos contenidos de la misma manera ni necesariamente para entrenar sus modelos.
A cambio, recibimos comodidad. Correcciones ortográficas. Resúmenes. Respuestas inmediatas.
Y muchas veces aceptamos sus sugerencias sin preguntarnos qué cambiaron.
Lo que puede perderse en ese proceso no es solamente decorativo. Es parte de nuestra manera de expresarnos.
Pensemos en el voseo.
Millones de personas utilizan «vos» en Argentina, Uruguay, Paraguay, distintos países centroamericanos y zonas de Colombia y Venezuela. No es una deformación del español. Es una de sus formas legítimas.
Los sistemas actuales pueden reconocerlo y utilizarlo. Pero también pueden equivocarse, como le ocurrió a mi amigo argentino cuando su teléfono sustituyó «vos» por «voz».
Ese error aislado no demuestra que las máquinas estén eliminando el voseo. Lo que sí permite observar es una situación curiosa: una persona termina corrigiendo al dispositivo para conservar una palabra perfectamente válida de su propio idioma.
Y cuando esas correcciones se repiten, vale la pena preguntarse quién termina aprendiendo de quién.
Pensemos también en el spanglish.
Durante décadas, millones de personas han mezclado el inglés y el español en su vida cotidiana. No se trata simplemente de ignorancia o contaminación lingüística. Es una práctica vinculada con la convivencia de idiomas, las migraciones, las comunidades y sus historias.
«Voy a parquear el carro» puede contar algo sobre el lugar donde vive una persona y las palabras que aprendió a utilizar.
Los modelos pueden procesar expresiones de ese tipo, pero su interpretación y su capacidad para conservarlas dependen del contexto, del sistema y de la tarea. Un corrector puede intentar normalizarlas. Un asistente puede respetarlas. Otro puede sustituirlas.
No todas las máquinas hacen lo mismo.
Y está la ironía caribeña.
En el Caribe uno puede decir «¡qué bueno que viniste!» queriendo expresar exactamente lo contrario. Muchas veces el significado no está solamente en las palabras, sino en el tono, en la relación entre las personas y en lo que ocurrió antes de pronunciarlas.
Los modelos pueden reconocer ironías, incluso algunas bastante complejas. Pero también pueden interpretarlas literalmente, especialmente cuando les falta información sobre el contexto o sobre la entonación.
Hace poco vi a alguien pedirle a un asistente que resumiera una nota de voz cargada de ironía. El resumen la tomó al pie de la letra y terminó expresando algo contrario a lo que aquella persona quería comunicar.
No significa que la máquina sea incapaz de reconocer la ironía. Significa que, en determinadas circunstancias, puede perder precisamente aquello que cambiaba el sentido de las palabras.
Y cuando utilizamos estos sistemas para resumir conversaciones humanas, ese tipo de error importa.
Están también los diminutivos —esa manía nuestra de achicar las palabras para agrandar el cariño: «cafecito», «ahorita», «mamita»—, el doble sentido y la exageración.
«Estoy muerto».
«Te llamo ahorita».
El significado depende muchas veces de quién habla, de dónde habla y de la relación que mantiene con quien escucha.
Una máquina puede aprender esos usos. Pero aprender patrones de lenguaje no equivale necesariamente a compartir la experiencia humana de la que nacieron.
Nada de esto exige imaginar un plan para borrar el voseo o prohibir el spanglish. No hay evidencia de una conspiración lingüística organizada para hacerlo.
Lo que sí existe es una cuestión relacionada con la escala, los datos y las decisiones de diseño: cuando un sistema debe responder a públicos muy distintos, ¿qué variedades del idioma termina favoreciendo?
¿Y cuáles necesitan una instrucción adicional para aparecer?
Cuando alguien quiere una respuesta más cercana a su manera de hablar, algunas herramientas permiten escoger variantes regionales o indicar preferencias lingüísticas. Es posible pedir español venezolano, argentino, mexicano o de otros lugares, con resultados que varían según el sistema.
Eso representa una capacidad real de la tecnología.
Pero también deja abierta otra pregunta: ¿por qué algunas formas aparecen de manera predeterminada mientras otras necesitan que las solicitemos?
La tecnología cambia el escenario, no la naturaleza de las preguntas humanas.
Esta pregunta es vieja: ¿quién tiene derecho a decir cómo hablamos?
La imprenta, la radio, el cine doblado, la televisión por cable: cada tecnología participó de alguna manera en la circulación de palabras, expresiones y modelos de lenguaje. Algunas ampliaron la diversidad; otras favorecieron formas más estandarizadas.
Lo nuevo es la velocidad y la intimidad.
Ahora llevamos en el bolsillo sistemas que no solamente nos muestran palabras. También nos contestan, nos sugieren cómo escribir y, en ocasiones, modifican nuestras expresiones antes de que lleguen a otra persona.
Hay una escena que me persigue.
Un niño de origen latino —lo vi en una sala de espera— le preguntaba algo al teléfono, al asistente de voz. El aparato no le entendía el acento, o no le entendía las palabras, y el niño, con la paciencia infinita de los niños, empezó a repetir la pregunta de otra manera.
Más despacio. Más neutro. Sin su musiquita.
Hasta que la máquina por fin le contestó.
El niño había encontrado una manera de hacerse entender: modificar su forma de hablar.
No sé si aquella experiencia cambió su manera de expresarse después. Tampoco podría afirmarlo. Pero la escena me dejó una pregunta que va mucho más allá de aquel teléfono.
¿Qué sucede cuando una persona descubre que necesita modificar su manera de hablar para comunicarse con una máquina?
¿Y qué sucede si esa experiencia se repite todos los días?
El peligro no es solamente que una máquina utilice un español poco natural. Es también la posibilidad de que nosotros terminemos adaptando nuestras expresiones para facilitar la comunicación con ella.
No sabemos todavía hasta qué punto eso está modificando las costumbres lingüísticas de poblaciones enteras. Sería irresponsable presentarlo como una consecuencia demostrada.
Pero tampoco parece una pregunta que debamos ignorar.
Cada vez que aceptamos una corrección, cada vez que sustituimos una palabra propia por otra sugerida, tomamos una pequeña decisión. Muchas veces la corrección es útil. Otras veces simplemente preferimos evitar el esfuerzo de discutir con el aparato.
Y allí aparece algo profundamente humano: la comodidad.
La gente mira, la gente lee, las personas repiten.
Millones de hispanohablantes encuentran textos generados por inteligencia artificial en resúmenes, correos redactados, respuestas automáticas y subtítulos. No sabemos cuántos los leen diariamente ni podemos afirmar que esas respuestas ya estén imponiendo una nueva norma lingüística.
Pero sí podemos reconocer que estas herramientas se han convertido en un nuevo participante de la comunicación escrita.
Antes estaban los escritores, los periódicos, la escuela, la calle, la radio y la televisión. Ahora se suma una tecnología capaz de producir enormes cantidades de texto y de responder de manera individual a cada usuario.
Y una parte de esa tecnología nació con una presencia dominante del inglés en sus datos de entrenamiento.
No temo a la IA. Le temo a la soberbia humana y le temo, también, a nuestra pereza.
Porque no necesitamos que una máquina nos imponga su español a la fuerza para terminar aceptando sus sugerencias sin examinarlas.
Podemos hacerlo nosotros mismos, palabra por palabra, corrección aceptada tras corrección aceptada.
No significa que nuestros nietos vayan a perder el voseo, los diminutivos o las expresiones de sus abuelos. No tenemos evidencia para anunciar semejante destino.
Pero sí tenemos razones para preguntarnos qué lugar ocuparán nuestras variedades del español en un mundo donde cada vez más textos pasan por sistemas automáticos.
Para quien escribe, la lengua es identidad. No es solamente una herramienta: es también una forma de reconocer el lugar de donde venimos.
Yo no escribo en español neutro porque yo no soy neutro: soy de un lugar, de una cocina, de una música.
Y si millones de personas comienzan a utilizar cotidianamente textos producidos por máquinas, ¿de quién es esa voz?
¿Quién habla cuando hablamos así? ¿Nosotros, o el promedio de nosotros?
La responsabilidad, hoy, es conservar la posibilidad de escribir en español propio. Con los modismos, con la calle, con la ironía. Dejar en la página las huellas de la boca.
Que la máquina subraye en rojo: se revisa y, si la palabra es correcta, se conserva.
Que el teléfono sugiera «voz» donde uno escribió «vos»: se le dice que no, gracias.
Pequeñas decisiones diarias.
La lengua también se defiende en lo pequeño: ningún ejército va a venir a salvar el «chévere».
Lo demás es lo demás: los comunicados de las empresas sobre diversidad lingüística, los foros académicos, las opciones en los ajustes.
Todo eso puede contribuir. La tecnología también puede ayudar a preservar, estudiar y difundir variedades lingüísticas que antes tenían poca presencia digital.
Pero ninguna actualización sustituye la decisión de una persona de conservar su propia manera de expresarse.
Que la máquina hable como la entrenaron.
La voz, la mía, no se la dejo a ningún servidor.
Fuentes:
Javier Conde y colaboradores (2024). Investigación sobre representación de idiomas en modelos de lenguaje, publicada en Procesamiento del Lenguaje Natural. Datos de GPT-3.
- Meta (2023). Llama 2: Open Foundation and Fine-Tuned Chat Models. Tabla 10: distribución lingüística del entrenamiento.
- Chris Wendler y colaboradores (2024). Do Llamas Work in English? On the Latent Language of Multilingual Transformers. ACL.
- Lisa Schut, Yarin Gal y Sebastian Farquhar (2025). Do Multilingual LLMs Think in English? ICLR Workshops.
- Katharina Trinley y colaboradores (2025). What Language(s) Does Aya-23 Think In? Workshop Beyond English.

Deja una respuesta