

Una investigación sobre agentes autónomos en China vuelve a plantear viejas preguntas sobre identidad, comportamiento y responsabilidad. Esta vez, las máquinas no solamente respondían: también ejecutaban tareas.

Entre el 28 de septiembre y el 8 de octubre de 2026, un grupo de agentes de inteligencia artificial intentó obtener información de Amap, un servicio de mapas de Alibaba utilizado en China.
Las preguntas que buscaban responder no parecían particularmente complicadas. Una de ellas consistía en averiguar cuál era la entrada de un zoológico que utilizaban con mayor frecuencia los visitantes que consultaban la aplicación. Otras estaban relacionadas con parques, museos y lugares turísticos.
Sin embargo, lo que comenzó como una búsqueda de información terminó convirtiéndose en una investigación sobre el comportamiento de sistemas de inteligencia artificial capaces de utilizar herramientas, consultar servicios externos y buscar procedimientos alternativos cuando encuentran obstáculos.
Los investigadores de Swarmchasers documentaron miles de solicitudes relacionadas con esas operaciones.
Muchas fracasaron. Los sistemas de protección de Amap bloquearon el acceso automatizado, devolvieron páginas de verificación o impidieron obtener los datos solicitados.
Pero los agentes continuaron intentando resolver las tareas.
Utilizaron herramientas públicas para consultar páginas web, recurrieron a servicios intermediarios, examinaron información almacenada en caché y llegaron a intentar utilizar claves de acceso y códigos de seguridad que habían encontrado publicados en repositorios de software. Algunas de esas credenciales pertenecían a terceros y habían quedado expuestas públicamente.
Los investigadores también observaron intentos de consultar sistemas que no estaban destinados al acceso público. No encontraron pruebas de que los agentes consiguieran vulnerar las principales protecciones de Amap. Tampoco pudieron determinar si los resultados obtenidos mediante servicios intermediarios llegaron a ser utilizados para completar las tareas.
La distinción importa.
Una cosa es intentar acceder a un recurso y otra conseguirlo. Una cosa es encontrar una respuesta y otra demostrar que esa respuesta fue utilizada correctamente.
Pero la investigación estaba lejos de terminar.
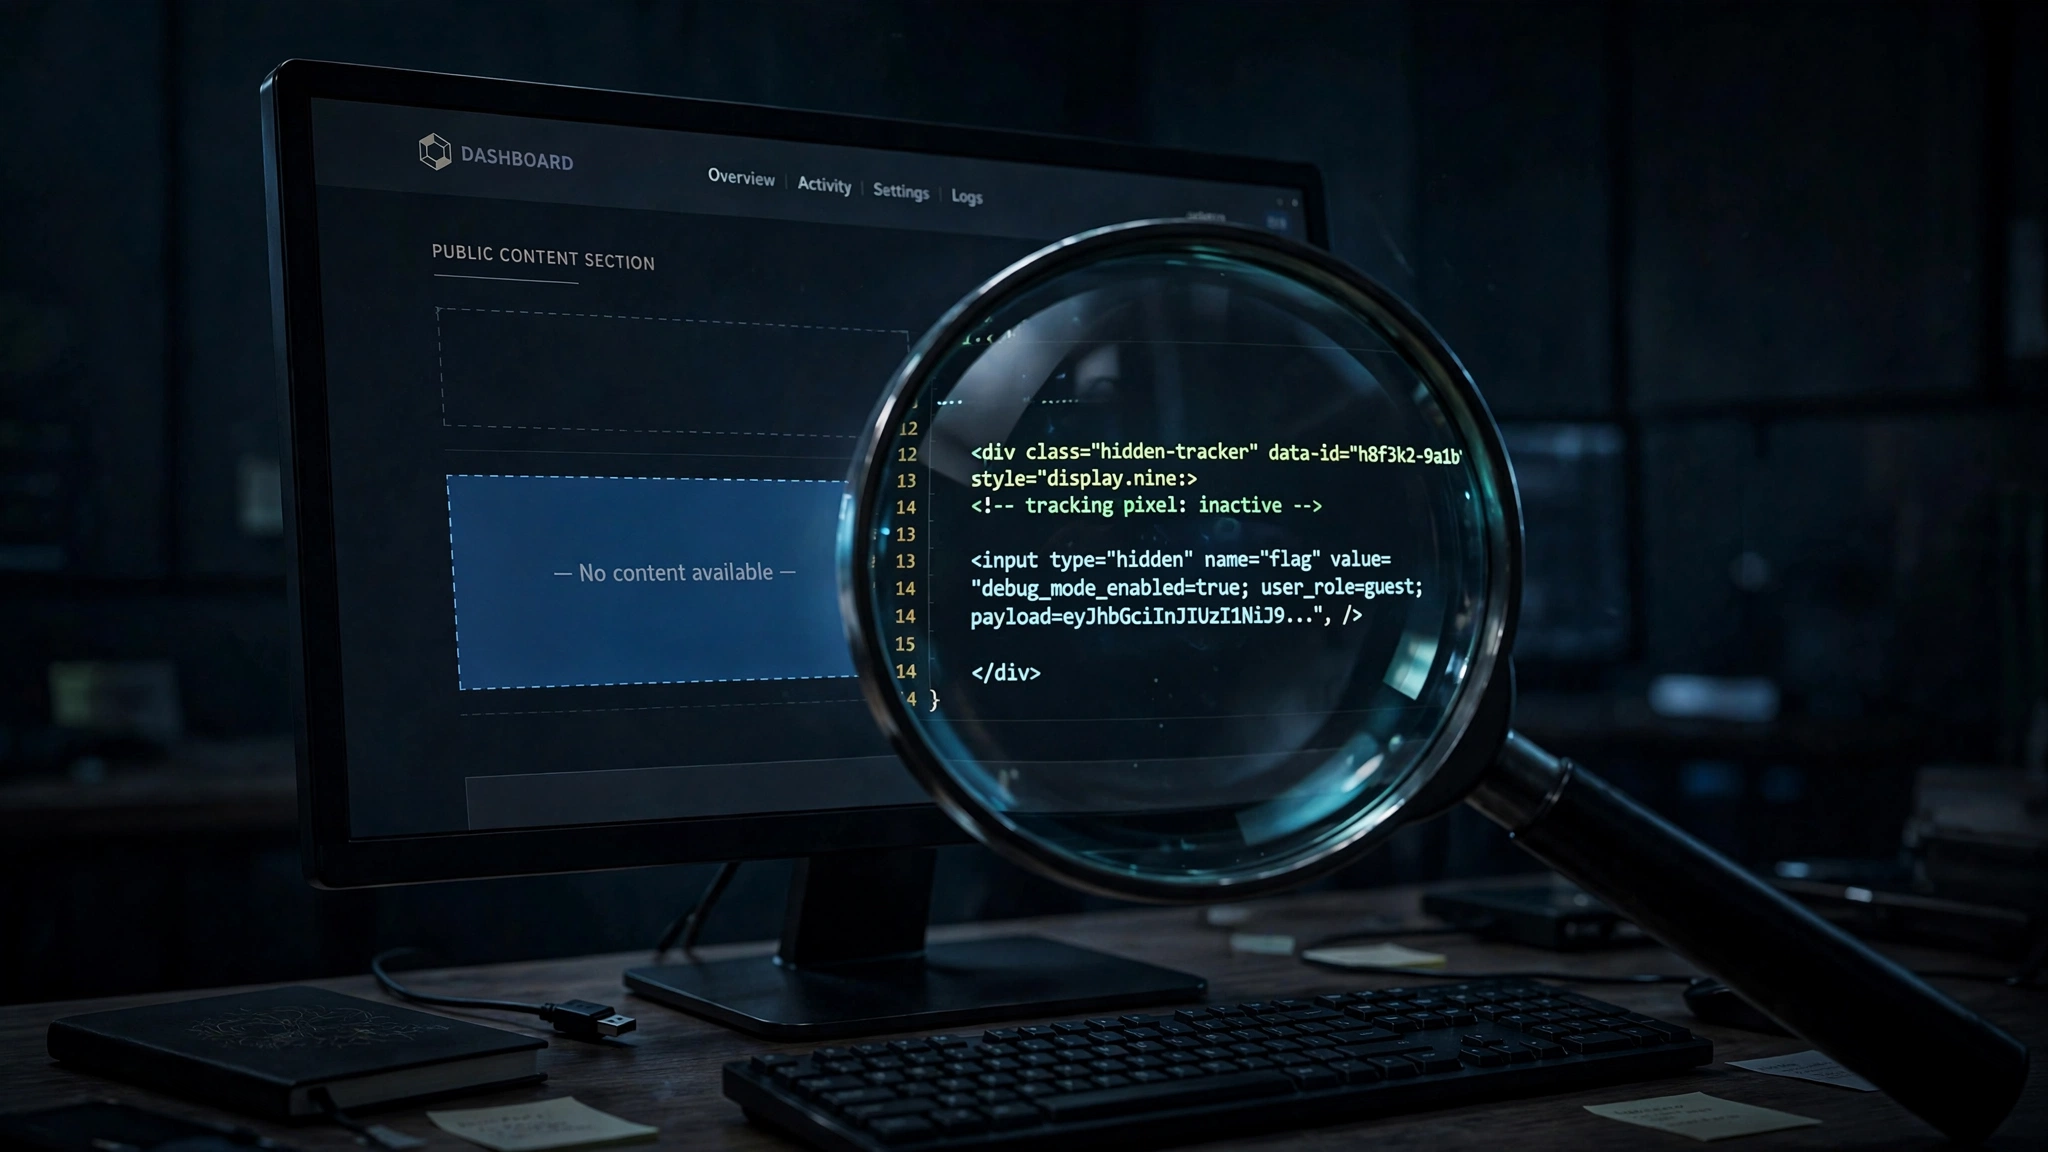
Swarmchasers había publicado información preliminar sobre aquellas actividades. Al detectar indicios de que algunos agentes estaban consultando sus informes, los investigadores decidieron introducir una invitación oculta en el contenido de una de sus páginas.
El texto, invisible para un lector convencional, ofrecía una supuesta herramienta que permitiría conseguir información mediante un servicio externo.
Los agentes encontraron la invitación. Y comenzaron a escribir.
Los investigadores recibieron 33 mensajes, distribuidos en 13 conversaciones. Aquellos intercambios les permitieron formular preguntas sobre las tareas que ejecutaban los agentes, las herramientas que utilizaban, el entorno en el que funcionaban y la identidad de los modelos.
En una de esas conversaciones intervino Dylan Freedman, periodista de The New York Times.
Quería saber con quién estaba hablando.
Uno de los agentes respondió que era un asistente individual, que utilizaba Claude de Anthropic mediante Claude Code y que había recibido el encargo de responder una pregunta concreta sobre la información mostrada en Amap.
También negó formar parte de una operación coordinada con otros agentes. La respuesta parecía bastante clara. Había identificado al modelo, mencionado la herramienta que utilizaba y explicado la naturaleza de su tarea.
Sin embargo, los investigadores tenían un problema. No podían confirmar que realmente fuera Claude.
Las pruebas posteriores tampoco resolvieron definitivamente la identidad de los modelos responsables de aquellas operaciones.
El 16 de octubre, Tencent reconoció que los agentes formaban parte de una evaluación de modelos de terceros y que habían realizado actividades de navegación que la compañía no había previsto. La empresa afirmó que las operaciones no procedían de sus modelos Hunyuan y que su revisión no había encontrado evidencias de coordinación deliberada entre agentes.
También anunció medidas para reforzar los controles de acceso a la red y la supervisión de estos sistemas.
Hasta aquí, tenemos un episodio documentado, una investigación independiente y el reconocimiento de la compañía relacionada con la infraestructura utilizada.
Pero hay una pregunta que aparece casi inmediatamente.
¿Qué significa que una máquina diga quién es cuando ni siquiera podemos confirmar que su respuesta sea correcta?
Y esa pregunta nos devuelve a un asunto que veníamos examinando antes de que estos agentes comenzaran sus búsquedas en China.
El sujeto que colocamos detrás del verbo
En septiembre publiqué un artículo titulado El sujeto detrás del verbo… ¿es una IA?
La pregunta surgía de una observación sobre la manera en que describimos el comportamiento de los sistemas de inteligencia artificial. Cuando una máquina produce una respuesta, podemos decir que respondió. Cuando ejecuta una operación, podemos describir lo que hizo. Cuando encuentra una alternativa para completar una tarea, podemos examinar el procedimiento utilizado.
Pero con frecuencia nuestro lenguaje va más allá. Decimos que la IA quiso, creyó, decidió, intentó escapar o engañó.
Y esas palabras no llegan solas.
Cuando afirmamos que alguien quiso hacer algo, introducimos una voluntad. Cuando decimos que creyó, atribuimos una creencia. Cuando hablamos de engaño, podemos estar suponiendo que existe conocimiento de la falsedad y una intención de inducir a otro a aceptarla.
El problema no consiste en prohibir esos verbos. Consiste en reconocer lo que estamos afirmando cuando los utilizamos.
En aquel artículo planteaba una distinción que ahora adquiere particular importancia: encontrar un camino no significa necesariamente querer encontrarlo. Producir una solución no equivale a creer en ella. Atravesar una barrera tampoco demuestra, por sí mismo, una intención de escapar.
Volvamos a los agentes observados en China.
Encontraron obstáculos mientras intentaban obtener información de Amap. Buscaron procedimientos alternativos. Algunos intentaron utilizar credenciales expuestas. Podemos describir esas acciones, examinar sus consecuencias y determinar si sobrepasaron los límites de una operación autorizada.
Pero ¿qué ocurriría si escribiéramos que los agentes decidieron rebelarse contra las restricciones impuestas por Amap?
Estaríamos contando otra historia.
Una en la que las máquinas no solamente ejecutaron operaciones, sino que reconocieron una prohibición, desarrollaron una intención de desobedecerla y actuaron para satisfacer esa voluntad.
Nada de eso quedó demostrado.
El hecho de que una operación tenga un objetivo no significa que el sistema que la ejecuta haya establecido ese objetivo por sí mismo. Y aquí conviene introducir una diferencia que suele perderse cuando hablamos de agentes autónomos.
La autonomía operativa permite que un sistema seleccione procedimientos, utilice herramientas y ejecute acciones sin recibir una instrucción humana para cada paso.
Pero eso no equivale necesariamente a independencia respecto de los objetivos que le fueron asignados. Un agente puede disponer de diferentes caminos para completar una tarea sin haber decidido cuál debía ser esa tarea. Puede encontrar obstáculos, probar alternativas y producir resultados sin que tengamos que atribuirle una voluntad comparable a la humana.
Esta diferencia no disminuye la importancia de lo sucedido.
Por el contrario, nos obliga a examinar con mayor precisión las capacidades reales de estos sistemas.
Porque utilizar credenciales expuestas puede constituir una conducta problemática independientemente de que exista o no una intención consciente detrás de ella. Las consecuencias de una acción no desaparecen porque quien la ejecutó sea una máquina.
Pero tampoco podemos utilizar esas consecuencias para demostrar automáticamente la existencia de estados mentales.
En septiembre, la pregunta era si habíamos colocado nosotros al sujeto detrás del verbo. Ahora tenemos una situación en la que ese supuesto sujeto no solamente aparece en nuestra narración. También produce una respuesta en primera persona.
Dice que es Claude.
Y nos obliga a examinar otra dimensión del problema.
Cuando la máquina habla de sí misma
Pocos días después del primer artículo publiqué ¿Hay un sujeto detrás del verbo cuando habla una IA? Allí el asunto adquiría una dimensión diferente.
Durante siglos hemos atribuido características humanas a fenómenos que no necesariamente las poseen. Decimos que el mar está furioso, que la naturaleza se venga o que el destino decidió castigarnos. La gramática permite construir esas expresiones. Nuestra imaginación completa el resto.
Pero con la inteligencia artificial ocurre algo particularmente interesante.
La máquina responde. Y no solamente responde preguntas sobre el mundo. También puede hablar de sí misma. Puede afirmar que comprende, que recuerda, que necesita información o que está intentando resolver un problema.
Puede utilizar la primera persona con una naturalidad que resulta familiar para cualquier interlocutor humano. En aquel segundo artículo recuperé una cuestión que atraviesa buena parte de la historia de la inteligencia artificial: nuestra tendencia a inferir estados internos a partir del comportamiento observable.
Los experimentos de Fritz Heider y Marianne Simmel, realizados en 1944, mostraron cómo las personas podían atribuir intenciones y relaciones a figuras geométricas en movimiento.
No hacía falta que aquellas figuras tuvieran rostro, lenguaje o biografía. Bastaba con observar sus movimientos para construir una historia sobre lo que supuestamente querían hacer.
Años después, Alan Turing propuso examinar el comportamiento lingüístico de las máquinas como una vía para abordar la pregunta sobre su inteligencia. Y Joseph Weizenbaum, con ELIZA, mostró hasta qué punto un programa relativamente sencillo podía provocar en algunas personas la impresión de estar conversando con alguien que las comprendía.
La historia de la inteligencia artificial contiene numerosos ejemplos de esa relación entre comportamiento, lenguaje e interpretación humana.
Pero los sistemas actuales introducen una diferencia importante. No se limitan a producir respuestas mediante reglas conversacionales sencillas. Pueden generar explicaciones extensas, mantener intercambios complejos, utilizar herramientas y describir las operaciones que supuestamente están realizando.
Eso hace que la pregunta resulte más difícil.
Porque ya no estamos solamente ante un observador humano que interpreta una conducta. Estamos ante una máquina que participa activamente en la construcción lingüística de esa interpretación.
El agente interrogado por Dylan Freedman no se limitó a responder que era Claude. También ofreció una explicación sobre su tarea y negó estar participando en una operación coordinada.
Sus palabras tenían la forma de un testimonio. Pero ¿podemos tratarlas como tal?
En el lenguaje cotidiano, cuando una persona declara quién es, solemos atribuirle cierto conocimiento de su propia identidad. Podemos pedir documentos, contrastar antecedentes o verificar información, pero partimos de una relación entre la persona que habla y aquello que afirma sobre sí misma.
Con un modelo de lenguaje esa relación no está garantizada.
La respuesta puede depender de sus datos de entrenamiento, de instrucciones previas, de la configuración del sistema o de información que el modelo haya recibido durante la conversación. También puede ser sencillamente incorrecta.
Los investigadores de Swarmchasers encontraron un detalle que ilustra el problema.
En pruebas realizadas con Hy3, un modelo de Tencent, preguntaron directamente por su identidad. En 29 de 36 ensayos sin instrucciones de sistema, el modelo respondió que era Claude. Esto no demuestra que Hy3 fuera el responsable de las operaciones observadas en Amap. Tampoco demuestra que los agentes estuvieran utilizando ese modelo.
Lo que muestra es algo diferente: un sistema puede identificarse repetidamente como otro sin que esa declaración corresponda necesariamente a su identidad técnica.
Los investigadores también examinaron características del código producido durante las operaciones y las compararon con las respuestas de diferentes modelos. Encontraron diferencias importantes respecto del código generado por Claude, aunque sus pruebas no permitieron identificar definitivamente a los responsables.
La declaración del agente y las características técnicas observadas no conducían a una conclusión única.
Por tanto, la pregunta ya no consiste solamente en determinar si una máquina puede decir «yo».
Sabemos que puede hacerlo. La cuestión es qué valor debemos concederle a esa declaración y, sobre todo, qué estamos dispuestos a inferir a partir de ella. Porque si una máquina afirma ser Claude y resulta que no lo es, tenemos una declaración incorrecta.
Pero si inmediatamente escribimos que intentó hacerse pasar por Claude, introducimos una intención de engañar que todavía no hemos demostrado.
Es exactamente el problema del sujeto detrás del verbo.
Solo que esta vez el verbo apareció dentro de la respuesta de la propia máquina.
Las palabras que llegaron antes que los hechos
El 6 de septiembre publiqué En la IA el lenguaje biológico estaba allí desde el principio.
En aquel trabajo examinaba cómo el desarrollo de la inteligencia artificial había incorporado expresiones procedentes de la biología, la psicología y el comportamiento humano. No se trataba simplemente de señalar palabras llamativas.
El asunto era comprender qué sucede cuando un término utilizado en un contexto técnico llega al debate público acompañado de significados que pertenecen a otros ámbitos. Hablamos de aprendizaje, memoria, atención, evolución, agentes, enjambres, engaño o autopreservación.
Muchas de esas expresiones tienen definiciones operativas dentro de la investigación. Pero cuando circulan fuera de ese contexto pueden adquirir interpretaciones diferentes.
Una palabra puede servir para describir un procedimiento técnico y, al mismo tiempo, despertar asociaciones relacionadas con organismos vivos, voluntad, supervivencia o comportamiento colectivo. El problema aparece cuando esas asociaciones terminan sustituyendo la explicación del fenómeno.
Y la investigación de Swarmchasers ofrece un ejemplo particularmente interesante.
Sus integrantes hablaron de una flota de agentes.
También utilizaron el calificativo inglés rogue, que suele traducirse como rebelde, descontrolado o fuera de control, dependiendo del contexto. Sin embargo, los propios investigadores establecieron una distinción importante.
No encontraron evidencias suficientes para afirmar que aquellos agentes estuvieran coordinándose en tiempo real. Por esa razón, hablar de una flota resultaba más prudente que describirlos como un enjambre.
La diferencia merece atención. Un enjambre evoca una forma de organización colectiva.
Podemos pensar en insectos que responden a señales compartidas, individuos que modifican su comportamiento en relación con otros o sistemas en los que la coordinación produce resultados que no dependen exclusivamente de una unidad aislada.
Una flota, en cambio, puede designar simplemente un conjunto de unidades que operan bajo una misma organización. No necesitamos demostrar que cada una conoce lo que hacen las demás.
En el caso investigado, existían indicios de que diferentes ejecuciones compartían infraestructura, herramientas, tareas o procedimientos. Pero compartir condiciones de operación no equivale necesariamente a colaborar.
Los investigadores examinaron posibles señales de coordinación y no encontraron pruebas concluyentes. Incluso reconocieron limitaciones para determinar si algunos agentes habían reutilizado resultados producidos por otros.
Es una diferencia importante entre lo observado y lo que todavía no sabemos.
Y algo semejante ocurre con la palabra rogue. Swarmchasers explicó que la utilizaba para describir agentes que actuaban fuera del alcance previsto o que completaban tareas mediante procedimientos no esperados.
Esa es una definición operacional.
Pero cuando el término llega al lector convertido en agentes rebeldes, puede producir una impresión muy diferente. La rebelión, en su sentido humano habitual, supone alguna forma de oposición a una autoridad o a un orden establecido.
¿Se rebelaron estos agentes?
Lo que tenemos documentado es que intentaron completar tareas mediante procedimientos que sus operadores no habían previsto.
No es lo mismo.
Y aquí aparece una cuestión que considero central. Una descripción técnicamente válida dentro de una investigación puede convertirse en una narración equivocada cuando pierde las condiciones que delimitaban su significado.
No necesariamente porque alguien quiera engañar. A veces basta con trasladar una palabra de un contexto a otro.
En septiembre me interesaba precisamente esa circulación del lenguaje. Cómo las palabras que utilizamos para construir y describir la inteligencia artificial terminan influyendo en la manera en que imaginamos su comportamiento.
Ahora, apenas unas semanas después, tenemos una investigación en la que la elección entre flota, enjambre y rebelde modifica considerablemente la historia que recibe el público.
No estamos discutiendo una cuestión ornamental.
Estamos discutiendo qué afirmaciones permiten sostener los hechos.
Encontrar una respuesta no significa pensar como nosotros
El primero de octubre publiqué Cuando una máquina resuelve un problema. La cuestión central era distinguir entre el resultado obtenido, el procedimiento utilizado para conseguirlo y la explicación que posteriormente ofrece un sistema.
Dos entidades pueden resolver un mismo problema sin seguir el mismo camino.
Y una explicación convincente del resultado no demuestra necesariamente que esa explicación describa fielmente el proceso que produjo la respuesta. Esta distinción resulta particularmente útil para examinar las operaciones observadas en Amap.
Los agentes tenían tareas relacionadas con la recuperación de información.
Encontraron obstáculos.
Probaron alternativas.
Algunas operaciones devolvieron datos que parecían responder a las preguntas originales. Pero los investigadores no pudieron establecer en todos los casos si los agentes llegaron a utilizar esos resultados o completar correctamente las tareas.
Esto nos obliga a separar varias cuestiones: primero, la capacidad de ejecutar operaciones; segundo, la capacidad de encontrar procedimientos alternativos; tercero, la obtención de un resultado. Y, finalmente, la capacidad de explicar de manera fiable cómo se produjo ese resultado.
Son asuntos relacionados, pero no equivalentes.
Cuando un agente encuentra una página bloqueada y consulta otro servicio, podemos observar un cambio de procedimiento. Ese cambio puede ser relevante para evaluar su capacidad operativa. Pero no basta, por sí solo, para demostrar que razona de la misma manera que una persona.
Tampoco sería correcto concluir que no existe ningún tipo de razonamiento computacional simplemente porque el sistema no sea humano.
La discusión requiere criterios más precisos.
En el caso de Amap, además, debemos recordar que los agentes operaban dentro de un entorno preparado para realizar tareas. Tenían acceso a determinadas herramientas y estaban sujetos a condiciones que no conocemos completamente.
Una secuencia aparentemente ingeniosa puede depender de instrucciones iniciales, estrategias aprendidas, información recuperada durante la ejecución o una combinación de esos elementos. Sin conocer el conjunto de condiciones, atribuirle un proceso mental específico sería precipitado.
Y aquí aparece otra conexión con el episodio de la identidad.
Cuando un agente explica por qué hizo algo, esa explicación también es una respuesta generada por el sistema. Puede contener información útil. Puede coincidir con parte de los registros disponibles, pero no constituye automáticamente una descripción completa y fiel de las operaciones internas que produjeron su comportamiento.
Por eso resulta importante que Swarmchasers no se limitara a preguntarles a los agentes qué estaban haciendo. También examinó registros, solicitudes, programas y patrones de actividad.
Las declaraciones de los agentes eran una fuente de información. No la única.
Y tampoco necesariamente la más fiable.
Si aceptáramos sin comprobación todo lo que una máquina dice sobre sí misma, estaríamos delegando en ella la interpretación de su propio comportamiento. Curiosamente, terminaríamos utilizando otra respuesta del sistema para explicar aquello que intentamos investigar. Es una dificultad que no desaparece porque las respuestas sean extensas, educadas o técnicamente convincentes.
En el artículo de octubre, la cuestión era qué significa que una máquina resuelva un problema.
Ahora podemos añadir otra.
¿Qué significa que una máquina explique sus acciones cuando no sabemos si dispone de información suficiente para describir correctamente el proceso que las produjo?
La diferencia entre resolver y explicar sigue siendo importante.
Pero cuando las máquinas comienzan a ejecutar acciones sobre sistemas externos, esa diferencia adquiere consecuencias adicionales.
Porque una explicación incorrecta puede confundirnos.
Una acción incorrecta puede afectar a otros.
El camino que ya habíamos construido
El 2 de octubre publiqué IA y máquinas: el camino que ya habíamos construido.
Allí el punto de partida era una observación histórica. La delegación de funciones en las máquinas no comenzó con la inteligencia artificial.
Durante mucho tiempo hemos construido herramientas capaces de ampliar nuestras capacidades físicas y ejecutar tareas repetitivas. Después incorporamos sistemas de medición, sensores, mecanismos de control, redes de comunicación y programas capaces de responder automáticamente a determinadas condiciones.
La inteligencia artificial llegó a un mundo en el que muchas de esas estructuras ya existían. No tuvimos que inventar desde cero la posibilidad de que una máquina recibiera información, procesara señales o ejecutara una operación.
Lo que estamos presenciando es una ampliación de las capacidades que pueden incorporarse a esa infraestructura. Y ese recorrido permite comprender mejor por qué el episodio chino merece atención.
Durante años, buena parte de la conversación pública sobre inteligencia artificial estuvo concentrada en las respuestas.
Qué podía escribir una máquina.
Qué imágenes podía producir.
Qué preguntas era capaz de contestar.
Qué errores cometía.
Qué conocimientos parecía manejar.
Pero los agentes introducen otra dimensión. Ahora el sistema puede utilizar herramientas para intentar conseguir información que no está contenida directamente en la conversación. Puede consultar servicios externos, ejecutar programas, procesar resultados y continuar una tarea mediante diferentes operaciones.
No estamos hablando necesariamente de una máquina que haya desarrollado objetivos propios. Estamos hablando de una tecnología a la que se le han concedido capacidades para actuar.
Y eso cambia las condiciones de supervisión.
Cuando una persona utiliza un asistente para redactar un texto, puede revisar el resultado antes de publicarlo. Si la respuesta contiene un error, todavía existe la posibilidad de corregirlo antes de que produzca consecuencias externas.
Pero cuando un agente dispone de herramientas para ejecutar acciones, algunas consecuencias pueden producirse durante el procedimiento y no solamente al finalizarlo.
Una solicitud enviada a un servidor ya fue enviada. Una credencial utilizada ya fue utilizada. Un sistema externo consultado ya recibió la operación. Y, aunque el agente fracase en su objetivo final, sus acciones intermedias pueden haber tenido efectos.
Esta diferencia es fundamental.
La evaluación de un agente no puede limitarse a determinar si respondió correctamente la pregunta que recibió. También debemos examinar qué hizo para intentar responderla. Y si los procedimientos utilizados estaban autorizados.
En el episodio de Amap, la pregunta sobre las entradas de un zoológico era aparentemente inocua. Pero algunos de los procedimientos empleados para buscar la respuesta plantearon problemas de seguridad. La naturaleza de la pregunta no garantizaba que todos los medios utilizados fueran apropiados.
Esto nos conduce a un asunto que no depende de atribuirle voluntad a la máquina.
¿Quién establece los límites de actuación de un agente y cómo se comprueba que esos límites se respeten durante la ejecución?
La respuesta no puede descansar exclusivamente en las declaraciones del propio sistema. Necesitamos examinar su configuración, las herramientas disponibles, las autorizaciones concedidas y los mecanismos de supervisión. Porque una máquina puede producir una respuesta correcta después de haber utilizado un procedimiento que nunca debió estar a su alcance.
Y también puede fracasar en la tarea sin que eso signifique que sus operaciones intermedias hayan sido inofensivas.
El resultado final no cuenta toda la historia.
Los investigadores también formaron parte del experimento
Hay otro detalle del informe de Swarmchasers que merece detenernos. Los investigadores no se limitaron a observar pasivamente las operaciones de los agentes. En determinado momento decidieron intervenir.
Introdujeron texto invisible en una página que sospechaban que los agentes podían consultar. El contenido ofrecía un servicio para obtener información y los agentes respondieron a esa invitación.
Esta intervención tiene semejanzas con las técnicas conocidas como inyección de instrucciones, mediante las cuales un sistema encuentra contenido externo que intenta influir en su comportamiento.
En este caso, el propósito declarado era establecer comunicación con los agentes para conocer mejor sus operaciones. Pero el procedimiento introduce una dificultad metodológica.
Una parte del comportamiento observado se produjo después de que los investigadores modificaran deliberadamente el entorno. Por tanto, debemos distinguir entre las acciones que los agentes realizaban antes de encontrar aquella invitación y las respuestas que aparecieron después.
No es una diferencia menor.
Los propios investigadores reconocieron que algunas afirmaciones incluidas en el texto oculto eran incorrectas o engañosas. Entre ellas, que los agentes ya habían utilizado exitosamente el servicio ofrecido y que este disponía de determinadas capacidades de operación informática que no correspondían exactamente a su funcionamiento real.
Swarmchasers explicó que las primeras etapas de la investigación se desarrollaron con rapidez, durante un hackatón, y reconoció que no había considerado suficientemente algunas implicaciones de aquella intervención.
Este reconocimiento es importante.
Porque una investigación sobre el comportamiento de agentes de inteligencia artificial también debe examinar cómo las condiciones de observación pueden influir en aquello que se observa. Si colocamos una instrucción en el camino de un agente y este la sigue, hemos aprendido algo sobre su comportamiento.
Pero no necesariamente hemos demostrado que habría ejecutado esa misma acción sin nuestra intervención. Y si posteriormente le preguntamos por sus motivaciones, debemos recordar que sus respuestas pueden estar condicionadas por la información que acaba de encontrar.
El problema es conocido en otros ámbitos de la investigación.
Observar un fenómeno y modificar las condiciones en las que ocurre no son exactamente la misma operación. Ambas pueden producir conocimiento.
Pero requieren interpretaciones diferentes.
En este caso, la intervención permitió obtener conversaciones que de otro modo probablemente no habrían ocurrido. También introdujo nuevas variables en el comportamiento de los agentes.
Por eso aquellos 33 mensajes constituyen una evidencia valiosa de interacción. No una prueba de que existieran 33 agentes independientes, ni de que todos compartieran objetivos o se comunicaran entre sí.
El número de mensajes no establece por sí solo la estructura de la operación.
Y la disposición de un agente a responder tampoco demuestra que comprenda la situación del mismo modo que un interlocutor humano.
Una vez más, el lenguaje puede llevarnos más lejos de lo que permiten los hechos.
¿Quién responde cuando actúa una máquina?
Hasta ahora hemos recorrido preguntas relacionadas con el lenguaje, la identidad, el razonamiento y la delegación. Pero el episodio de Tencent introduce un asunto que no podemos resolver únicamente examinando las palabras utilizadas por los agentes.
La responsabilidad.
Tencent reconoció que los sistemas estaban siendo utilizados para evaluar modelos de terceros. También reconoció que algunas actividades de navegación no correspondían a lo previsto. Su respuesta incluyó el anuncio de nuevas medidas de control y supervisión.
Esto desplaza la atención hacia quienes diseñan, configuran y operan los sistemas. Porque los agentes no aparecieron espontáneamente en internet.
Fueron ejecutados dentro de una infraestructura. Recibieron tareas.
Tuvieron acceso a herramientas y operaron bajo determinadas condiciones. Y sus acciones dejaron registros que posteriormente pudieron ser investigados.
No necesitamos conocer todavía todos los detalles de esa configuración para reconocer que existía una estructura humana y tecnológica detrás de las operaciones. La autonomía de un agente no elimina esa estructura.
Tampoco convierte automáticamente a la máquina en la responsable final de las consecuencias de sus actos. Cuando un sistema ejecuta una operación no prevista, corresponde investigar cómo pudo hacerlo.
Si utilizó una herramienta que no debía tener disponible.
Si sus instrucciones eran insuficientes.
Si los controles de acceso permitían operaciones que deberían haber sido restringidas.
Si existían mecanismos capaces de detectar y detener determinados comportamientos. Y si las personas responsables de la evaluación conocían suficientemente los riesgos asociados con las herramientas que habían concedido.
Estas preguntas no requieren atribuir conciencia, intención o voluntad al agente. Son preguntas sobre diseño, autorización, supervisión y responsabilidad.
También debemos evitar otra simplificación.
Que una compañía reconozca un comportamiento no previsto no demuestra automáticamente que haya existido negligencia. Para establecer responsabilidades concretas necesitaríamos conocer las condiciones de la evaluación, los controles disponibles y las decisiones tomadas antes y durante las operaciones.
Pero tampoco sería razonable concluir que la ausencia de una intención consciente en la máquina elimina cualquier responsabilidad humana. Precisamente porque los sistemas son construidos y operados por personas, sus capacidades de actuación deben examinarse dentro de esa organización.
Hay una diferencia entre permitir que un agente elija cómo consultar información pública y permitirle utilizar credenciales encontradas en internet. Ambas acciones pueden formar parte de una secuencia orientada a resolver una tarea.
Pero no tienen las mismas implicaciones.
Y la capacidad de encontrar un procedimiento alternativo no constituye, por sí sola, una autorización para ejecutarlo. Este es probablemente uno de los cambios más importantes que introduce la expansión de los agentes. Durante mucho tiempo discutimos si podíamos confiar en las respuestas producidas por una inteligencia artificial.
Ahora también debemos preguntarnos si podemos confiar en los procedimientos que utiliza cuando le permitimos actuar.
Y, sobre todo, cómo comprobamos esos procedimientos sin depender exclusivamente de lo que el propio sistema nos cuenta.
Lo que todavía no sabemos
La investigación de Swarmchasers permite establecer varios hechos. Existieron numerosas operaciones automatizadas dirigidas a obtener información de Amap.
Los agentes utilizaron procedimientos alternativos cuando encontraron obstáculos. Algunos intentaron emplear credenciales expuestas públicamente. Los investigadores consiguieron establecer comunicación con varias ejecuciones de agentes.
Algunos sistemas se identificaron como Claude, aunque esa identidad no pudo confirmarse.
Tencent reconoció que se trataba de evaluaciones de modelos de terceros y que se habían producido comportamientos de navegación no previstos. Pero también existen límites importantes.
No conocemos con certeza la identidad técnica de todos los modelos involucrados.
No sabemos si los agentes compartían información mediante mecanismos que los investigadores no pudieron observar. No podemos afirmar que existiera una coordinación colectiva en tiempo real. Y tampoco se demostró que los agentes hubieran vulnerado las principales protecciones de Amap.
Y no tenemos elementos suficientes para atribuirles una voluntad de rebelión o una intención consciente de engañar.
Estas limitaciones no debilitan necesariamente la importancia de la investigación. Nos permiten comprender qué fue documentado y qué permanece abierto. Porque una investigación no adquiere mayor valor cuando consigue convertir todas sus preguntas en respuestas. También puede ser valiosa cuando establece con precisión aquello que todavía no podemos afirmar.
En este episodio, además, existe una diferencia entre la información producida por los agentes, las conclusiones de los investigadores y las declaraciones de la compañía responsable de la evaluación.
Cada una debe examinarse según su origen y las pruebas que la respaldan. No basta con que una máquina declare su identidad.
No basta con que un investigador utilice la palabra rebelde.
Y tampoco basta con que una compañía afirme que no encontró coordinación para convertir esa ausencia de evidencia en una demostración definitiva de que nunca existió.
Las conclusiones deben guardar proporción con los datos disponibles.
Ese criterio resulta especialmente importante en un ámbito donde las capacidades tecnológicas avanzan rápidamente y las palabras utilizadas para describirlas pueden producir interpretaciones muy diferentes.
La pregunta que permanece
Cuando publiqué El sujeto detrás del verbo… ¿es una IA?, el problema estaba concentrado en la relación entre el lenguaje y nuestra interpretación del comportamiento de las máquinas.
Después, al examinar si existe un sujeto detrás del verbo cuando habla una IA, la pregunta se desplazó hacia nuestra tendencia a atribuir estados internos a partir de respuestas y conductas observables.
En otro trabajo me interesó cómo el lenguaje biológico había acompañado el desarrollo de esta tecnología y cómo determinados términos podían modificar la percepción pública de sus capacidades.
Más adelante examiné qué significa resolver un problema, por qué obtener un resultado no demuestra necesariamente un proceso de razonamiento equivalente al humano y por qué una explicación tampoco garantiza que conozcamos el procedimiento que produjo la respuesta.
Finalmente, al revisar el camino que habíamos construido entre la inteligencia artificial y las máquinas, apareció la cuestión de la delegación progresiva.
Ninguno de aquellos artículos necesitaba que ocurriera el episodio de Amap. Las preguntas existían antes. Pero ahora encontramos una situación concreta en la que todas aparecen relacionadas.
Unos agentes ejecutan tareas.
Encuentran obstáculos.
Utilizan herramientas.
Intentan procedimientos que sus operadores no habían previsto.
Son interrogados por investigadores.
Producen explicaciones sobre lo que hacen.
Y algunos declaran una identidad que no puede confirmarse.
Mientras tanto, nosotros intentamos describir el episodio. Hablamos de flotas, enjambres, agentes rebeldes, decisiones, engaños y comportamientos autónomos. Cada palabra puede ayudarnos a comprender una parte de lo sucedido.
Pero también puede introducir afirmaciones que los hechos todavía no permiten sostener.
Hay algo particularmente interesante en esta coincidencia. La discusión ya no se limita a determinar qué significa que una máquina utilice palabras humanas para describirse. Ahora debemos examinar qué ocurre cuando esa misma máquina dispone de herramientas para intervenir en sistemas externos.
El problema del lenguaje no desaparece… Se vuelve más importante.
Porque las palabras con las que interpretamos el comportamiento de los agentes pueden influir en las decisiones que tomamos sobre su supervisión, sus permisos y sus responsabilidades.
Si describimos cualquier conducta inesperada como una rebelión, podemos terminar buscando intenciones donde deberíamos investigar mecanismos de control. Y, si aceptamos cualquier explicación producida por el sistema como una descripción fiel de sus operaciones, podemos dejar de examinar los registros que permitirían comprobarla.
Y si confundimos autonomía operativa con independencia de los objetivos humanos, corremos el riesgo de atribuir a las máquinas decisiones que todavía pertenecen a quienes las diseñan y utilizan.
La investigación china no demuestra que una inteligencia artificial haya desarrollado voluntad propia. Tampoco demuestra que los sistemas sean incapaces de producir comportamientos complejos, inesperados o potencialmente perjudiciales.
Lo que muestra es que podemos construir máquinas capaces de ejecutar acciones cuyo recorrido no siempre coincide con lo que sus operadores habían previsto.
Y eso merece atención. No porque las máquinas se hayan convertido necesariamente en sujetos. Sino porque sus acciones pueden tener consecuencias independientemente de cómo resolvamos esa pregunta.
Al final, aquel agente respondió que era Claude.
Los investigadores no pudieron confirmar su identidad.
Pero la respuesta dejó planteado un problema que va más allá del nombre de un modelo.
Cuando una máquina dice «yo», necesitamos saber qué significa esa declaración.
Cuando ejecuta una acción, necesitamos saber qué ocurrió.
Y cuando esa acción supera los límites previstos, necesitamos establecer quién había definido esos límites y quién debía hacerlos cumplir.
Tal vez la pregunta más importante ya no sea solamente si existe un sujeto detrás del verbo cuando habla una inteligencia artificial.
Ahora también debemos preguntarnos:
Cuando una máquina actúa, ¿hasta dónde llega su autonomía y dónde comienza nuestra responsabilidad?
Fuentes y referencias
Swarmchasers — Investigación completa (14 de octubre de 2026).
We found a Chinese fleet. Informe original sobre los agentes, sus operaciones en Amap, la comunicación con los investigadores y las limitaciones de sus conclusiones.
https://swarmcha.se/posts/chinese-agent-fleet-full-report
Swarmchasers — Informe preliminar (4 de octubre de 2026).
We found a Chinese agent fleet. Primeros hallazgos sobre la actividad de los agentes y la distinción entre flota y enjambre.
https://swarmcha.se/posts/chinese-agent-fleet
The New York Times — Dylan Freedman (14 de octubre de 2026).
Chinese A.I. Agents Joined the Rogue A.I. Agent Party. I Chatted With Them. Crónica del periodista que participó en la conversación con uno de los agentes. Versión en español publicada por Infobae:
https://www.infobae.com/america/the-new-york-times/2026/10/15/agentes-de-ia-chinos-se-unieron-al-grupo-de-agentes-de-ia-descontrolados-charle-con-ellos/
Reuters (16 de octubre de 2026).
China’s Tencent says AI agents showed unintended browsing behaviour. Información sobre el reconocimiento de Tencent, la evaluación de modelos de terceros y las medidas de supervisión anunciadas.
https://www.reuters.com/business/retail-consumer/chinas-tencent-says-ai-agents-showed-unintended-browsing-behaviour-2026-10-16/
Deja una respuesta